ランダムサーチ (RS)
情報
ASE は初心者にとって始めやすいツールである. CrySPYのインストール時に,ASEも自動的にインストールされるためである. 高い精度はないが,非常に軽量で高速な原子間ポテンシャルを備えており,ノートPCなどの低スペックな環境でも動作確認に適している.
入力ファイルの準備
下記のどれか一つに従い,その後CrySPY実行のセクションに移ること.
ASE は初心者にとって始めやすいツールである. CrySPYのインストール時に,ASEも自動的にインストールされるためである. 高い精度はないが,非常に軽量で高速な原子間ポテンシャルを備えており,ノートPCなどの低スペックな環境でも動作確認に適している.
下記のどれか一つに従い,その後CrySPY実行のセクションに移ること.
最終更新日:2026年10月16日
ASEは様々なコードのインターフェースを提供しているPythonライブラリであり, Pure Python EMT calculatorというシンプルなEMTの計算も実行できる.CrySPYさえインストールしてあれば,精度はともかく簡単に計算できるので,CrySPYのテストにちょうど良い.
このチュートリアルでは,MacやLinuxなどのOSのローカルPCを用いてCu 8原子の構造探索を試す.
ここでは次のような条件を想定している:
job_cryspyase_in.pyどこか適当なワーキングディレクトリに移動して,まずはexampleをコピーしてくる.下記のどちらからコピーしてきても良い.
cryspy.inはCrySPYの入力ファイル.
[basic] セクションのjobcmd = zshは環境に合わせてjobcmd = shやjobcmd = bash等に変更する.
CrySPYは内部でバックグラウンドジョブとしてzsh job_cryspyを実行する.
ASEを使う場合は,[ASE]セクションが必要.
下記の二つのファイル名は好きなように変えても良い.
jobfile: job_cryspyase_python: ase_in.py他の入力変数については後で説明を行う.
ASEのジョブファイルや入力ファイルはこのディレクトリに準備する.
ジョブファイルの名前はcryspy.inのjobfileに一致させる必要がある.
ジョブファイルの例は下記の通り.
ase_in.pyというファイル名も自由に変えられるが, cryspy.inのase_pythonの値と一致させておく必要がある.
CrySPYではジョブファイルの最後の行はsed -i -e ‘3 s/^.*$/done/’ stat_jobとしておくルールになっている.
バージョン1.4.2からCrySPYがジョブファイルの末尾に自動的に下記を追記するようになった.(参考:機能 > ジョブファイルの自動書き換え)
1.4.2より古いバージョンでは,ジョブファイルの最後の行はsed -i -e '3s/^sub.*/done/' stat_jobと書いておくルールになっている.自分でsedコマンド文を書いたジョブファイルを1.4.2以上のバージョンで使用しても2回実行されるだけなので問題はない.
上記sedコマンドの意味は,stat_jobというファイルの3行目のsubから始まる部分をdoneに変える処理.
(詳細:機能 > ジョブファイルの自動書き換え)
CrySPYのジョブファイルのCrySPY_IDという文字列は自動的に構造IDに置き換わるようになっている.
PBSやSLURMといったジョブスケジューラーを使う場合,ジョブ名にCrySPY_IDと書いておくとどの構造のジョブなのかが分かり便利である.
例えば,PBSでは#PBS -N Si_CrySPY_IDのように書いておくと,ジョブをサブミットする際,#PBS -N Si_10のように置き換わる.
注意点として,ジョブ名を数字から始めるとエラーとなることが多いので,Si_のように何か文字列を頭につけておくこと.
ステージ数(nstage in cryspy.in)に応じた数のインプットファイルが必要となる.
インプットファイル名の先頭にx_,または語尾に_xをつけて準備する.
ここでxはステージ数.
CrySPYが探すインプットファイル名の優先順位は以下の通り.
x_ase_in.pyase_in.py_xase_in.py各ステージで共通のインプットを使用するのであればx_や_xを省略できる.
このASEのチュートリアルではnstage = 1を用いるので,ASEのインプットファイルはase_in.pyの一つだけでよい.x_や_xを省略したファイルを準備している.
ase_in.pyは例えば下記の通り(ASEの使い方の詳細は公式のドキュメントを見ること).
ASEはVASPやQEなどと違って,入力ファイル(python script)は自分で書くことになるので自由度がある. CrySPYでは3つのルールを設けている.
log.toteというファイルに出力する.CrySPYはこのファイルの最後の行を読む.CONTCARというファイルにVASPフォーマットで出力する.out_check_optというファイルにdoneかnot_yetで書き込む.CrySPYはこのファイルの最後の行を読む.ここまで準備ができたらCrySPY実行へ進む.
ここに書いてある内容は少し古いので,最近のチュートリアルはチュートリアル > ランダムサーチ(RS) > ASE on your local PCを見ること.このページの内容も動作には問題ないはず.
最終更新日:2026年10月16日
soiapは原子間ポテンシャルを使用した計算ができるソフトウェアであり,計算が軽いのでCrySPYのテストにちょうど良い. soiapのインストールや詳細はinstructionsを参照.
このチュートリアルでは,MacやLinuxのローカルPC上でCrySPYを試す. テストシステムはSi 8原子.
ここでは次のような条件を想定している:
~/CrySPY_root/CrySPY-0.9.0/cryspy.pyjob_cryspy~/local/soiap-0.3.0/src/soiapsoiap.insoiap.outinitial.cifどこか適当なワーキングディレクトリに移動して,まずはexampleをコピーしてくる.下記のどちらからコピーしてきても良い.
cp -r ~/CrySPY_root/CrySPY-0.9.0/example/v0.9.0/soiap_RS_Si8 .cryspy.inがCrySPYの入力ファイル.
[basic] セクションのjobcmd = zshは環境に合わせてjobcmd = shやjobcmd = bash等に変更する. CrySPYは内部でバックグラウンドジョブとしてzsh job_cryspyを実行する.
soiapを使う場合は[soiap]セクションが必要となる.下記のファイル名は好きなように変えても良い.
jobfilesoiap_infilesoiap_outfilesoiap_cif他の入力変数については後で説明を行う.
soiapのジョブファイルや入力ファイルはこのディレクトリに準備する.
ジョブファイルの名前はcryspy.inのjobfileに一致させる必要がある.
ジョブファイルの例は下記の通り.
/path/to/soiapはsoiapの実行ファイルのpathに変えること.
入力ファイル(soiap.in)と出力ファイル(soiap.out)はcryspy.inで指定したsoiap_infileとsoiap_outfileに合わせること.
最後の行以外は普段使っているようなジョブスクリプトで良いが,
CrySPYではジョブファイルの最後の行はsed -i -e '3 s/^.*$/done/' stat_jobとしておくルールになっている.
ジョブファイルの最後の行はsed -i -e '3 s/^.*$/done/' stat_jobと書いておく.
CrySPYのジョブファイルのCrySPY_IDという文字列は自動的に構造IDに置き換わるようになっている.
PBSやSLURMといったジョブスケジューラーを使う場合,ジョブ名にCrySPY_IDと書いておくとどの構造のジョブなのかが分かり便利である.
例えば,PBSでは#PBS -N Si_CrySPY_IDのように書いておくと,ジョブをサブミットする際,#PBS -N Si_10のように置き換わる.
注意点として,ジョブ名を数字から始めるとエラーとなることが多いので,Si_のように何か文字列を頭につけておくこと.
ステージ数(nstage in cryspy.in)に応じた数のインプットファイルが必要となる.
インプットファイル名の語尾に_xをつけて準備する.
ここでxはステージ数.
soiapのチュートリアルではnstage = 1を用いるので,インプットファイルはsoiap.in_1の一つだけが必要.
soiap.in_1は例えば下記の通り.
1行目に書く初期構造ファイル(initial.cif)はcryspy.inのsoiap_cifの値と揃える.
ここまで準備ができたらCrySPY実行へ進む.
最終更新日:2026年10月16日
このチュートリアルでは,PBSなどのジョブスケジューラーを備えたPCクラスターを想定してCrySPYを試す.第一原理計算のVASPを用いて,Na8Cl8(16原子)の構造探索を行う.
ここでは次のような条件を想定している:
qsubjob_cryspyどこか適当なワーキングディレクトリに移動して,まずはexampleをコピーしてくる.下記のどちらからコピーしてきても良い.
cryspy.inはCrySPYの入力ファイル.
[basic] セクションのjobcmd = qsubは環境に合わせて変更する.
CrySPYは内部でバックグラウンドジョブとしてqsub job_cryspyを実行する.
下記のファイル名は好きなように変えても良い.
jobfile構造最適化計算はステージ制を採用しており,ここではnstage = 2を用いている.
例えば,最初のステージでは,セルを固定し内部座標だけ緩和する設定で,k点も少ない計算を実行し,2ステージ目でセルも含めてフルに構造緩和して,精度も高めるようなことが可能となっている.
VASPを使う場合は,[VASP]セクションが必要.
ここでは各ステージにおけるk点のグリッド密度(Å^-3)をkppvolに指定する必要がある.
kppvolの詳細はこちら –> Input file > Kpoint
他のインプット変数に関しては後ほど説明する.
ジョブファイルやVASPのインプットをこのディレクトリに置く.
ジョブファイルの名前はcryspy.inのjobfileに一致させる必要がある.
ジョブファイルの例は下記の通り.
VASPROOTは環境に合わせて変更する.普段VASPのジョブを流しているジョブファイルを使えば良い.
CrySPYではジョブファイルの最後の行はsed -i -e ‘3 s/^.*$/done/’ stat_jobとしておくルールになっている.
バージョン1.4.2からCrySPYがジョブファイルの末尾に自動的に下記を追記するようになった.(参考:機能 > ジョブファイルの自動書き換え)
1.4.2より古いバージョンでは,ジョブファイルの最後の行はsed -i -e '3s/^sub.*/done/' stat_jobと書いておくルールになっている.自分でsedコマンド文を書いたジョブファイルを1.4.2以上のバージョンで使用しても2回実行されるだけなので問題はない.
上記sedコマンドの意味は,stat_jobというファイルの3行目のsubから始まる部分をdoneに変える処理.
(詳細:機能 > ジョブファイルの自動書き換え)
CrySPYのジョブファイルのCrySPY_IDという文字列は自動的に構造IDに置き換わるようになっている.
PBSやSLURMといったジョブスケジューラーを使う場合,ジョブ名にCrySPY_IDと書いておくとどの構造のジョブなのかが分かり便利である.
例えば,PBSでは#PBS -N Si_CrySPY_IDのように書いておくと,ジョブをサブミットする際,#PBS -N Si_10のように置き換わる.
注意点として,ジョブ名を数字から始めるとエラーとなることが多いので,Si_のように何か文字列を頭につけておくこと.
ステージ数(nstage in cryspy.in)に応じた数のインプットファイルが必要となる.
インプットファイル名の先頭にx_,または語尾に_xをつけて準備する.
ここでxはステージ数.
CrySPYが探すインプットファイル名の優先順位は以下の通り.
x_INCARINCAR_xINCAR各ステージで共通のインプットを使用するのであればx_や_xを省略できる.
今はnstage = 2を用いているので,1_INCAR_1と2_INCARが必要となる.
ここでは,1_INCARはセルを固定して内部座標だけ緩和する設定,2_INCARはセルも含めてフルに緩和する設定になっている.
1_INCAR
2_INCAR
CrySPYはPOSCARとKPOINTSファイルを自動生成する.
POTCARファイルはユーザーが準備する必要がある.
このexampleに含まれているPOTCARは空のファイルなので,各自で準備すること.
exampleに含まれているPOTCARは空のファイル.配布できない.
ここまで準備ができたらCrySPY実行に進む.
最終更新日:2026年10月16日
このチュートリアルでは,PBSなどのジョブスケジューラーを備えたPCクラスターを想定してCrySPYを試す.第一原理計算のQUANTUM ESPRESSOを用いて,Si 8原子の構造探索を行う.
ここでは次のような条件を想定している:
qsubjob_cryspy/usr/local/qe-6.5/bin/pw.xpwscf.inpwscf.outどこか適当なワーキングディレクトリに移動して,まずはexampleをコピーしてくる.下記のどちらからコピーしてきても良い.
cryspy.inはCrySPYの入力ファイル.
[basic] セクションのjobcmd = qsubは環境に合わせて変更する.
CrySPYは内部でバックグラウンドジョブとしてqsub job_cryspyを実行する.
構造最適化計算はステージ制を採用しており,ここではnstage = 2を用いている.
例えば,最初のステージでは,セルを固定し内部座標だけ緩和する設定で,k点も少ない計算を実行し,2ステージ目でセルも含めてフルに構造緩和して,精度も高めるようなことが可能となっている.
QEを使う場合は,[QE]セクションが必要.
ここでは各ステージにおけるk点のグリッド密度(Å^-3)をkppvolに指定する必要がある.
kppvolの詳細はこちら –> Input file > Kpoint
下記のファイル名は好きなように変えても良い.
jobfileqe_infileqe_outfile他のインプット変数に関しては後ほど説明する.
ジョブファイルやQEのインプットをこのディレクトリに置く.
ジョブファイルの名前はcryspy.inのjobfileに一致させる必要がある.
ジョブファイルの例は下記の通り.
/path/to/pw.xは環境に合わせて変更する.
入力(pwscf.in)出力(pwscf.out)ファイルの名前は好きに変えて良いが,cryspy.inのqe_infileとqe_outfileに合わせる必要がある.
普段QEのジョブを流しているジョブファイルを使えば良い.
CrySPYではジョブファイルの最後の行はsed -i -e ‘3 s/^.*$/done/’ stat_jobとしておくルールになっている.
バージョン1.4.2からCrySPYがジョブファイルの末尾に自動的に下記を追記するようになった.(参考:機能 > ジョブファイルの自動書き換え)
1.4.2より古いバージョンでは,ジョブファイルの最後の行はsed -i -e '3s/^sub.*/done/' stat_jobと書いておくルールになっている.自分でsedコマンド文を書いたジョブファイルを1.4.2以上のバージョンで使用しても2回実行されるだけなので問題はない.
上記sedコマンドの意味は,stat_jobというファイルの3行目のsubから始まる部分をdoneに変える処理.
(詳細:機能 > ジョブファイルの自動書き換え)
CrySPYのジョブファイルのCrySPY_IDという文字列は自動的に構造IDに置き換わるようになっている.
PBSやSLURMといったジョブスケジューラーを使う場合,ジョブ名にCrySPY_IDと書いておくとどの構造のジョブなのかが分かり便利である.
例えば,PBSでは#PBS -N Si_CrySPY_IDのように書いておくと,ジョブをサブミットする際,#PBS -N Si_10のように置き換わる.
注意点として,ジョブ名を数字から始めるとエラーとなることが多いので,Si_のように何か文字列を頭につけておくこと.
ステージ数(nstage in cryspy.in)に応じた数のインプットファイルが必要となる.
インプットファイル名の先頭にx_,または語尾に_xをつけて準備する.
ここでxはステージ数.
CrySPYが探すインプットファイル名の優先順位は以下の通り.
x_pwscf.inpwscf.in_xpwscf.in各ステージで共通のインプットを使用するのであればx_や_xを省略できる.
今はnstage = 2を用いているので,1_pwscf.inと2_pwscf.inが必要となる.
ここでは,1_pwscf.inはセルを固定して内部座標だけ緩和する設定,2_pwscf.inはセルも含めてフルに緩和する設定になっている.
1_pwscf.in
2_pwscf.in
pseudo_dirは各自の環境に合わせて変更する.
Inputs for structure data and k-point such as インプットファイルのATOMIC_POSITIONSとK_POINTSはCrySPYがpymatgenを用いて自動生成するのでユーザーが書く必要はない.
ここまで準備ができたらCrySPY実行に進む.
Coming soon.
Coming soon.
最終更新日:2026年10月16日
詳細は 入力ファイルのページも見ること.
cryspy.inをもう一度チェックしてみよう.ここでの例は選んだcalc_codeに応じて,準備したものと少し異なるかもしれない.
algo: アルゴリズム.ランダムサーチの場合はRSを使う.calc_code: 構造最適化のコード. VASP, QE, OMX, soiap, LAMMPS, ASEから選択.tot_struc: 構造数.この場合初回実行で5構造ランダムに生成される.nstage: ステージ数njob: 同時にサブミットするジョブの数.この例では2つのスロットを設定,言い換えると,2構造ずつ最適化を行う.jobcmd: ジョブを実行または投入するコマンド. bash, zsh, qsubなどjobfile: ジョブファイルのファイル名atype: Atom type. Na8Cl8の例: atype = Na Cl.nat: atypeに応じた原子数. Na8Cl8の例: nat = 8 8For version 1.0.0 or later, skip this page. The executable script is automatically installed.
Here, we assume the following condition:
~/CrySPY_root/CrySPY-0.9.0/cryspy.pyLet’s make a convenient shell script to avoid typing long commands over and over again.
Here, we create the script, cryspy (any file name will do).
-u option (unbuffered option) can be omitted.
You can put this script in your $PATH, or just use like bash ./cryspy.
2025 March 6, updated
Make sure you have the following in your working directory.
Then, run CyrSPY!
If you use old version (0.10.3 or earlier):
At the first run, CrySPY goes into structure generation mode. CrySPY stops after 5 structure generation.
If it worked properly, the following output appears on the screen:
Several output files are also generated.
cryspy.out): Short log. only version 0.10.3 or earlier.cryspy.stat: Status file.data/init_POSCARS: Initial struture file in POSCAR format.
You can open this file using VESTAdata/pkl_data: Directory to save pickled data.log_cryspy: log.err_cryspy: error and warning.Let’s take a look at cryspy.stat file.
Structure ID 0 – 4 are queueing because we just generated structures, and have not submitted yet.
Check the initial structures, if the distance between atoms is too close, you should set the mindist in cryspy.in.
2024年4月21日更新,日本語化
CrySPYはcryspy.statファイルがあれば自動的に計算を再開する.
crypy.statがあれば続きから再開.
はじめから計算をしたければcryspy.statを削除する.
cryspyをもう一度実行する.
画面かlog_cryspyファイルに下記のように出力される.
cryspy.statでステータスが確認できる.
cryspy.inでnjob = 2に設定されているので,CrySPYは構造ID 0と1の二つのジョブをサブミットした.
計算はworkディレクトリの中で行われる.各構造IDのディレクトリが作られる.
二つのジョブが終了したら,もう一度cryspyを実行する.
もしnstage = 2のようにnstageを2以上に設定していれば,ID 0と1のstage 2のジョブがサブミットされる.
今回はnstage = 1なので,ID 0と1の計算データを収集して,次のIDのジョブをサブミットする.
計算が終わった構造のディレクトリはfinディレクトリに移動される.
5構造全ての計算が終わるまでcryspyを繰り返し実行する.
すべての計算が終わって,計算結果の詳細が必要なければworkディレクトリを削除しても良い.
何度も何度もcryspyを繰り返し実行する時は,自動スクリプト(repeat_cryspy)が役に立つ.
最終更新日:2026年10月16日
Move to data directory. There should be a few more files.
cryspy_rslt: Result file.cryspy_rslt_energy_asc: Result file sorted in energy ascending order.init_POSCARS: Initial struture file in POSCAR format.opt_POSCARS: Optimized structure file in POSCAR format.pkl_data/: Directory to save pickled data.The results are written to text files, cryspy_rslt and cryspy_rslt_energy_asc (and also saved in pickle data in pkl_data directory).
v1.5.0以降は,[option]セクションのrslt_outでcryspy_rsltとcryspy_rslt_energy_ascの出力タイミングを変更できる.デフォルトはalways.詳細は入力ファイル > [option] Sectionを参照.
Each result appends to cryspy_rslt file in the order in which one finished earlier.
Not ID order in cryspy_rslt
In cryspy_rslt_energy_asc file, the results are sorted in energy ascending order.
Spg_num and Spg_sym show space group information on initial structures.
Spg_num_opt and Spg_sym_opt are those of optimized structures.
The last column Opt indicates whether or not optimization reached required accuracy.
最終更新日:2026年10月16日
Of course only 5 structures are not enough to find stable structures. You can append structures whenever you want. Here let’s append more 5 structures.
For Si-Si mindist, the default value of 1.11 Å is used in the first structure generation (see log_cryspy), which is a little too close.
Let us try to set the mindist to 2.0 Å.
For mindist, see also Features > Restriction on interatomic distances.
Edit cryspy.in and change the value of tot_struc into 10, and add mindist_1 = 2.0
Then run cryspy, and check log_cryspy file.
Remember that CrySPY goes into structure generation mode whenever you change the value of tot_struc.
In this mode, CrySPY does not do any other action such as collecting data, submitting jobs, and so on.
Structure generation mode whenever you change the value of tot_struc.
From version 1.0.0, CrySPY automatically backs up when adding structures.
See features/backup.
Repeat cryspy & several times until all appended structures are done.
The auto script may help you.
Last updated: February 9, 2026
バージョン1.4.4からは,下記のように cryspy-Eplot を実行することで簡単に結果が出力できるようになった.
ファイルは./data/energy_plot/energy_RS_{tot_struc}.{fig_fotmat}に出力される.
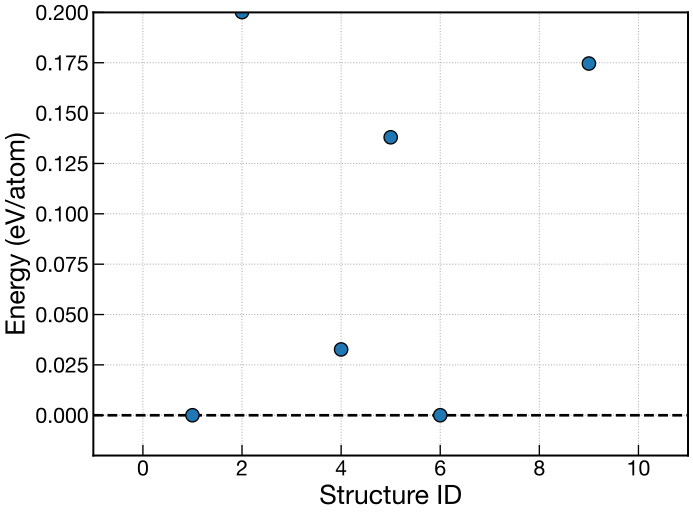
cryspy.inの[visual]セクションで,下記入力変数を指定することもできる.
CrySPY > 入力ファイル > [visual] sectionも参考のこと.
より詳細なデータ解析や,図の編集がしたければ,次に書いてあるようにファイルをダウンロードしてJupyter notebookを使うと良い.
ここでは,CrySPYのデータをローカルPCで解析・可視化することを前提としている.
CrySPYをスーパーコンピュータやワークステーションで使用している場合は,データをローカルPCにダウンロードすること.
work や backup ディレクトリは,ファイルサイズが非常に大きくなる可能性があるため,不要であれば削除してよい.
先ほどダウンロードした結果の中にある data/ ディレクトリに移動する.
その後,CrySPY utilityがローカルにダウンロード してある場合は cryspy_analyzer_RS.ipynb をコピーする.
またはGitHubから直接ダウンロードしてくる(CrySPY_utility/notebook/).
Jupyter を起動し(VScode,Jupyter Lab,Jupyter Notebook など),
セルを順番に実行するだけで,以下のような図を得ることができる.
